CÂU CHUYỆN ĐẰNG SAU KHÁI NIỆM
Vì sao một hàm đơn giản như ReLU lại hữu ích?
Năm 2011, Xavier Glorot, Antoine Bordes và Yoshua Bengio công bố nghiên cứu về mạng dùng hàm chỉnh lưu. Công trình cho thấy hàm max(0, x) có thể hỗ trợ việc học trong mạng nhiều lớp. Đây là một dấu mốc giúp ReLU trở nên phổ biến, không phải toàn bộ lịch sử của nó.
Glorot, Bordes và Bengio (2011)Ý tưởng này giúp ta làm gì?
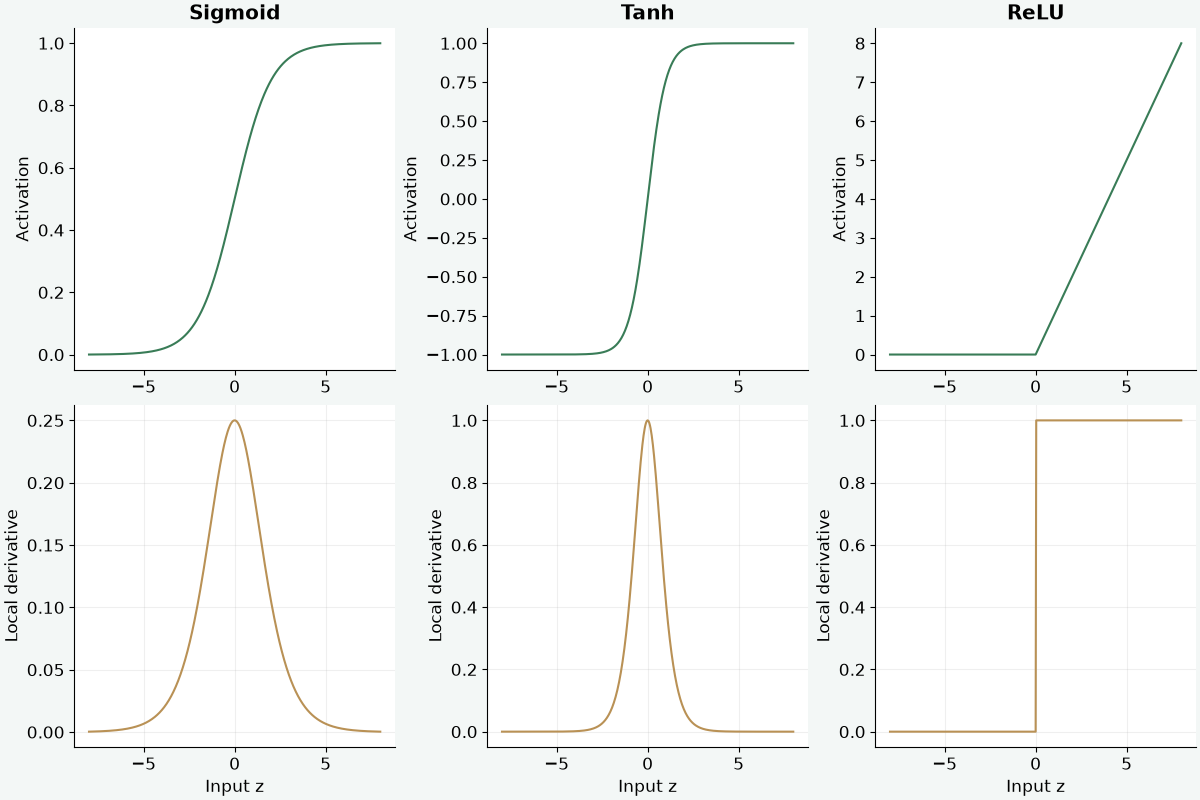
Sigmoid có vùng rất phẳng khi đầu vào lớn về trị tuyệt đối. Gradient đi qua nhiều vùng phẳng có thể nhỏ dần. ReLU giữ độ dốc bằng 1 ở phía dương, nhưng trả gradient bằng 0 ở phía âm. Mỗi lựa chọn đều có ưu điểm và giới hạn.
Thử nghĩ một chút Nếu đầu vào một nút ReLU luôn âm, trọng số trước nút đó nhận gradient gì?
BƯỚC 01
Bắt đầu từ đâu?
Học sau đạo hàm và sai phân. Cần biết hàm mũ, NumPy và đồ thị hàm số.
Bạn sẽ vẽ sigmoid, tanh, ReLU và đạo hàm của chúng. Các đường này giúp giải thích vì sao một số vùng làm gradient nhỏ hoặc bằng không.
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install numpy matplotlib
Ý nghĩa đoạn mã
Tạo môi trường riêng rồi gọi đúng Python trong môi trường. Không cần kích hoạt bằng một lệnh khác.
BƯỚC 02
Hàm mũ và độ dốc
Sigmoid đưa đầu vào về khoảng 0 đến 1, còn tanh về khoảng -1 đến 1. Cả hai có độ dốc nhỏ khi đầu vào có độ lớn lớn. Ta dùng biểu thức sigmoid ổn định để tránh exp của số dương quá lớn.
BƯỚC 03
Kiểm tra sai phân đúng nơi
So sánh gradient giải tích với sai phân ở các điểm cách xa góc gãy. Tại 0, sai phân trung tâm của ReLU trả 0.5 dù đạo hàm không tồn tại, nên kiểm tra máy móc có thể gây hiểu lầm.
points=np.array([-4.,-1.,0.7,3.])
h=1e-5
functions=[sigmoid,np.tanh,lambda x:np.maximum(x,0)]
analytic=[sigmoid(points)*(1-sigmoid(points)),
          1-np.tanh(points)**2,(points>0).astype(float)]
for fn,exact in zip(functions,analytic):
    numeric=(fn(points+h)-fn(points-h))/(2*h)
    assert np.allclose(numeric,exact,atol=1e-8)
relu_at_zero=(max(h,0)-max(-h,0))/(2*h)
assert relu_at_zero==0.5
print("Central difference of ReLU at 0:",relu_at_zero)
Ý nghĩa đoạn mã
Kiểm tra sai phân chỉ có ý nghĩa đạo hàm khi các điều kiện trơn phù hợp. Hàm có góc gãy cần xét đạo hàm một phía hoặc quy ước của thư viện.
Không gắn nhãn sai cho autograd chỉ vì khác sai phân tại điểm không khả vi.
BƯỚC 04
Quan sát gradient đi qua nhiều lớp
Quy tắc chuỗi nhân các đạo hàm cục bộ cùng trọng số. Nhiều thừa số nhỏ có thể làm gradient giảm mạnh. ReLU tránh bão hòa ở phía dương nhưng có vùng gradient bằng 0 ở phía âm.
fig,axs=plt.subplots(2,3,figsize=(12,8),layout="constrained")
for col,(values,grad,name) in enumerate(zip([sig,tan,relu],derivatives,["Sigmoid","Tanh","ReLU"])):
    axs[0,col].plot(z,values,color="#397c57")
    axs[0,col].set(title=name,ylabel="Activation")
    axs[1,col].plot(z,grad,color="#b99155")
    axs[1,col].set(xlabel="Input z",ylabel="Local derivative")
    axs[1,col].grid(alpha=0.2)
print("Ten sigmoid factors at maximal slope:",0.25**10)
fig.savefig(FIGURE, dpi=100)
plt.close(fig)
print("Saved:", FIGURE.name)
Ý nghĩa đoạn mã
Đồ thị ReLU dùng 0 tại gốc theo quy ước vừa nêu. Tích 0.25 mũ 10 chỉ minh họa các thừa số kích hoạt, chưa bao gồm trọng số của mạng.
Kiểm tra cả phân bố kích hoạt và gradient khi mô hình học chậm.
BƯỚC 05
Chạy thử và đọc kết quả
Đạo hàm sigmoid ở 0 bằng 0.25. Các phép kiểm tra ngoài góc gãy đều khớp và sai phân ReLU tại 0 bằng 0.5.
.\.venv\Scripts\python.exe calculus_activation_gradients.pyÝ nghĩa đoạn mã
Lệnh chạy toàn bộ tệp vừa tải. Nếu một assert không đúng, dừng lại và kiểm tra dữ liệu cùng bước tương ứng trước khi diễn giải hình.
Kiểm tra số liệu in ra trước, sau đó mới dùng hình để giải thích.
ĐẾN LƯỢT BẠN
Thử một thay đổi nhỏ
- Thử leaky ReLU với hệ số 0.1 ở nhánh âm.
- So sánh sai phân tại -2, 0 và 2 rồi giải thích trường hợp ở gốc.