BƯỚC 01
Nhãn cứng bỏ lại thông tin gì
Khi một mô hình trả về ba xác suất, nhãn có xác suất cao nhất chỉ giữ lại một phần thông tin. Hai lớp còn lại có thể gần ngang nhau hoặc khác nhau rất xa. Chưng cất tri thức cho mô hình học trò tiếp cận cả phân phối đầu ra của mô hình thầy. Mục tiêu thường là huấn luyện một mô hình nhỏ hơn, nhưng việc thêm xác suất mềm không bảo đảm mọi học trò đều tiến bộ.
Bài này mô phỏng mô hình thầy bằng một hàm khoảng cách đến ba tâm trên mặt phẳng. Học trò là lớp tuyến tính chỉ có chín tham số. Hai bản học trò bắt đầu từ cùng trọng số. Một bản học nhãn cứng, bản kia kết hợp nhãn cứng với phân phối mềm. Ta dùng dữ liệu riêng để đo mức đồng ý với quy tắc của thầy.
Thầy trong thí nghiệm không phải một mạng lớn đã huấn luyện. Cách dựng này giúp kiểm tra công thức và dòng gradient trên CPU mà không tải dữ liệu. Nó cũng làm rõ giới hạn của kết luận. Môi trường kiểm tra dùng PyTorch 2.13.0 và Matplotlib 3.11.1.
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install numpy matplotlib
.\.venv\Scripts\python.exe -m pip install torch --index-url https://download.pytorch.org/whl/cpu
Ý nghĩa đoạn mã
Tạo môi trường riêng ở thư mục thực hành. Lệnh cài PyTorch chọn bản CPU. Lưu chương trình Python ở cùng thư mục trước khi chạy.
BƯỚC 02
Nhiệt độ và chiều của độ lệch KL
Với logits của thầy là v và của trò là z, ta tạo hai phân phối và
BƯỚC 03
Giữ phép so sánh công bằng trong mã
Chương trình tạo 240 điểm huấn luyện và 1.200 điểm kiểm tra độc lập. Logits của thầy là âm hai lần bình phương khoảng cách từ điểm đến mỗi tâm. Nhãn cứng lấy argmax từ cùng quy tắc. Xác suất mềm được tính bên trong vùng không theo dõi gradient. Trong dự án thật, cần thêm teacher.eval để các lớp như Dropout và BatchNorm hoạt động theo chế độ suy luận.
Hai học trò được sao chép từ cùng trạng thái ban đầu, dùng cùng số bước và cùng tốc độ học. Cấu hình minh họa chọn T bằng 3 và lambda bằng 0,65. Đây là những giá trị cố định cho thí nghiệm, chưa được tối ưu trên tập kiểm tra. Chương trình kiểm tra mục tiêu giảm, tham số hữu hạn và xác suất thầy không yêu cầu gradient.
Mỗi bước dùng toàn bộ tập huấn luyện nhỏ để giảm nhiễu do lấy batch. Ngoài tỉ lệ đồng ý trên dữ liệu mới, ta tính KL trước và sau khi học. Hai chỉ số trả lời hai câu hỏi khác nhau: argmax có khớp không và phân phối xác suất có gần nhau không.
from pathlib import Path
import copy
import json
import torch
import torch.nn.functional as F
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt

torch.set_num_threads(1)
torch.manual_seed(43)
centers = torch.tensor([[-1.0, -0.3], [1.0, -0.3], [0.0, 1.2]])
def teacher_logits(features):
    return -2 * ((features[:, None, :] - centers[None, :, :]) ** 2).sum(-1)

x_train = torch.rand(240, 2) * 4 - 2
x_test = torch.rand(1200, 2) * 4 - 2
with torch.no_grad():
    z_teacher = teacher_logits(x_train)
    y_train = z_teacher.argmax(1)
    y_test = teacher_logits(x_test).argmax(1)
temperature, mix = 3.0, 0.65
soft_targets = F.softmax(z_teacher / temperature, dim=1)
student = torch.nn.Linear(2, 3)
baseline = copy.deepcopy(student)
histories = []
initial_state = copy.deepcopy(student.state_dict())
for model, use_kd in [(baseline, False), (student, True)]:
    optimizer = torch.optim.Adam(model.parameters(), lr=0.035)
    history = []
    for epoch in range(300):
        logits = model(x_train)
        hard = F.cross_entropy(logits, y_train)
        soft = F.kl_div(F.log_softmax(logits / temperature, dim=1), soft_targets, reduction='batchmean') * temperature**2
        loss = (1-mix) * hard + mix * soft if use_kd else hard
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        history.append(loss.item())
    histories.append(history)
    assert history[-1] < history[0]
with torch.no_grad():
    agreement_ce = (baseline(x_test).argmax(1) == y_test).float().mean().item()
    agreement_kd = (student(x_test).argmax(1) == y_test).float().mean().item()
    trained_kl = F.kl_div(F.log_softmax(student(x_train) / temperature, dim=1), soft_targets, reduction='batchmean').item()
    initial_student = torch.nn.Linear(2, 3)
    initial_student.load_state_dict(initial_state)
    initial_kl = F.kl_div(F.log_softmax(initial_student(x_train) / temperature, dim=1), soft_targets, reduction='batchmean').item()
assert trained_kl < initial_kl
assert not soft_targets.requires_grad
assert all(torch.isfinite(p).all() for p in student.parameters())

out = Path(__file__).resolve().parent / 'results'
out.mkdir(exist_ok=True)
plt.rcParams.update({'font.size': 11, 'figure.facecolor': '#f3f7f3'})
fig, ax = plt.subplots(1, 3, figsize=(13.5, 4.3), constrained_layout=True)
ax[0].scatter(x_train[:, 0], x_train[:, 1], c=y_train, cmap='viridis', s=12)
ax[0].set(title='Synthetic teacher labels', xlabel='Feature 1', ylabel='Feature 2')
probe = teacher_logits(torch.tensor([[0.2, 0.1]]))
for offset, temp, color in [(-0.18, 1.0, '#de873f'), (0.18, temperature, '#357a69')]:
    ax[1].bar(torch.arange(3)+offset, F.softmax(probe/temp, dim=1)[0], width=0.34, label=f'T = {temp:g}', color=color)
ax[1].set(title='Same logits, softer targets', xlabel='Class', ylabel='Probability', xticks=[0,1,2])
ax[1].legend()
ax[2].plot(histories[0], label='CE objective', color='#de873f')
ax[2].plot(histories[1], label='Mixed KD objective', color='#357a69')
ax[2].set(title='Different objectives, different meanings', xlabel='Optimization step', ylabel='Objective value')
ax[2].legend(fontsize=9)
fig.savefig(out / 'pytorch-knowledge-distillation.png', dpi=150)
metrics = {'test_agreement_ce': agreement_ce, 'test_agreement_kd': agreement_kd, 'initial_kl': initial_kl, 'trained_kl': trained_kl, 'teacher_grad_disabled': not soft_targets.requires_grad, 'student_parameters': sum(p.numel() for p in student.parameters())}
print(json.dumps(metrics))
(out / 'pytorch-knowledge-distillation.json').write_text(json.dumps(metrics, indent=2), encoding='utf-8')
BƯỚC 04
Đọc kết quả với đúng phạm vi kết luận
Trong lần chạy đã kiểm tra, học trò chỉ dùng nhãn cứng đồng ý với thầy ở khoảng 98,17% điểm kiểm tra. Học trò có chưng cất đạt khoảng 98,83%. KL trên tập huấn luyện giảm từ 0,5625 xuống 0,001196. Chênh lệch độ chính xác nhỏ này chỉ mô tả một seed, một bộ dữ liệu và một quy tắc mô phỏng. Nó không chứng minh chưng cất luôn tốt hơn.
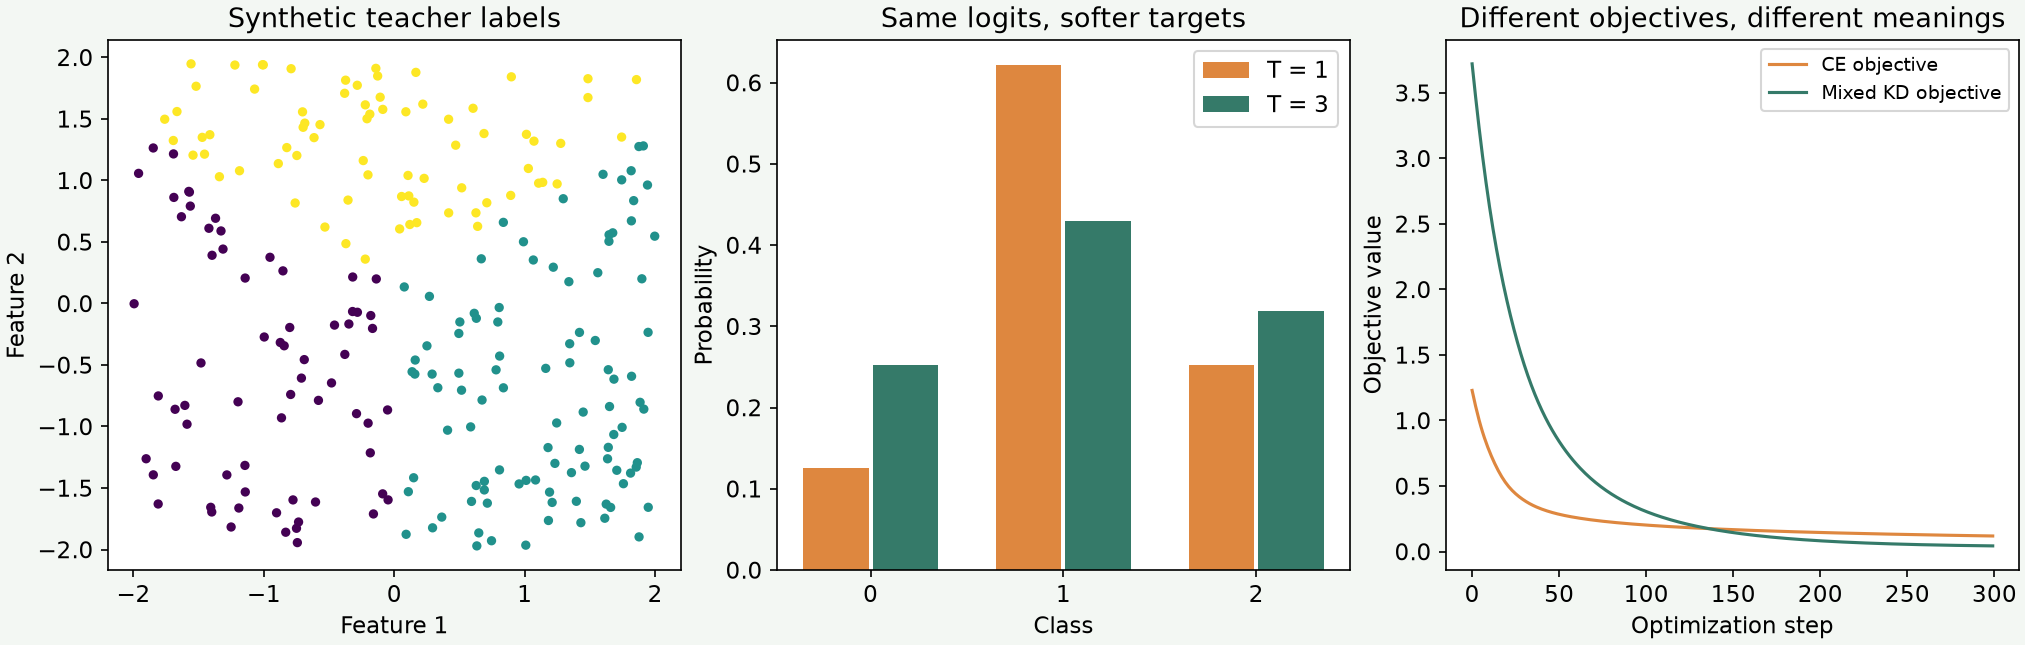
Hình giữa so sánh phân phối tại cùng một điểm khi T bằng 1 và 3. Các lớp ít được chọn nhận xác suất rõ hơn ở nhiệt độ lớn hơn. Hình bên phải vẽ hai mục tiêu tối ưu. Do công thức hai đường khác nhau, không được kết luận đường nào thấp hơn thì mô hình đó tốt hơn. Dùng dữ liệu và chỉ số đánh giá chung mới cho phép so sánh.
Tỉ lệ đồng ý với thầy cũng không phải độ chính xác đối với nhãn thực từ con người. Trong dữ liệu này, chính quy tắc thầy tạo nhãn chuẩn, nên hai khái niệm trùng nhau theo thiết kế. Với ảnh thật, thầy có thể sai và trò có thể học theo lỗi ấy.
.\.venv\Scripts\python.exe pytorch-knowledge-distillation.pyÝ nghĩa đoạn mã
Chương trình in số liệu JSON và lưu cả biểu đồ lẫn số liệu vào thư mục results cạnh tệp Python. Nhãn tiếng Anh trong hình tương ứng với tên biến trong mã.
BƯỚC 05
Áp dụng vào một bài toán ảnh thật
Giữ nguyên pipeline tiền xử lý mà thầy cần để tạo logits có ý nghĩa. Nếu thầy và trò dùng kích thước ảnh khác nhau, phải bảo đảm hai đầu vào vẫn đại diện cho cùng một mẫu và cùng nhãn. Với biến đổi ngẫu nhiên, cần quyết định rõ hai mạng nhìn cùng biến đổi hay các biến đổi khác nhau. Không ghép logits đã lưu sẵn với một ảnh khác chỉ vì chỉ số batch trùng nhau.
Nếu lưu logits để giảm chi phí huấn luyện, lưu kèm mã mẫu và thứ tự lớp. Thứ tự lớp khác nhau giữa thầy và trò khiến độ lệch KL vẫn tính được nhưng mục tiêu trở nên sai. Khi thầy là mạng thật, tắt gradient của thầy để tránh giữ đồ thị lớn và cập nhật tham số ngoài ý muốn.
Chọn T, lambda và lịch học trên validation rồi đánh giá một lần trên tập kiểm tra riêng. Ngoài chất lượng, đo dung lượng mô hình, độ trễ, bộ nhớ và mức tiêu thụ tài nguyên trên thiết bị đích. Học trò ít tham số hơn chưa chắc chạy nhanh hơn nếu phép toán của nó không phù hợp phần cứng.
BƯỚC 06
Giới hạn của thầy và của phép thử nhỏ
Hàm thầy theo bình phương khoảng cách có một đặc điểm thuận lợi. Khi trừ logits giữa hai lớp, thành phần bình phương độ dài của đầu vào triệt tiêu. Vì vậy ranh giới quyết định giữa các lớp là tuyến tính. Học trò tuyến tính trong bài có khả năng biểu diễn chính xác họ ranh giới ấy. Đây là lý do thí nghiệm nhỏ dễ đạt tỉ lệ đồng ý cao.
Một mạng thầy xử lý ảnh có thể tạo quan hệ phi tuyến mà học trò quá nhỏ không thể mô phỏng. Tăng nhiệt độ hoặc kéo dài huấn luyện không giải quyết được mọi giới hạn biểu diễn. Nếu thầy tự tin sai, xác suất mềm có thể truyền lỗi. Cần phân tích lỗi theo lớp và loại ảnh, thay vì chỉ nhìn một điểm số tổng hợp.
Cuối cùng, ví dụ chưa chứng minh mức nén vì thầy là hàm giải tích, không phải kiến trúc nhiều tham số. Kết quả hữu ích là mục tiêu được viết đúng, thứ tự KL được kiểm tra và phép so sánh hai cách học có điều kiện ban đầu nhất quán. Đó là nền tảng để triển khai chưng cất trên mạng ảnh thực tế.
ĐẾN LƯỢT BẠN
Thử một thay đổi nhỏ
- Chạy T bằng 1, 2 và 4 với cùng trạng thái khởi tạo, giữ lambda cố định.
- Ghi tỉ lệ đồng ý và KL cho từng cấu hình.
- Tạo thêm một tập validation nếu muốn chọn T, không chọn bằng điểm kiểm tra.
- Sau đó đảo nhãn một vùng của dữ liệu thầy và quan sát học trò có truyền lại lỗi ấy hay không.