BƯỚC 01
Thêm một nơi giám sát đặc trưng trung gian
Một mạng phân đoạn sâu có thể gắn thêm đầu phân lớp ở đặc trưng trung gian. Đầu này dự đoán nhãn trong lúc huấn luyện để tạo thêm tín hiệu tối ưu cho phần mạng phía trước. Nó được gọi là nhánh phụ vì dự đoán chính vẫn đến từ nhánh cuối. PSPNet là một ví dụ sử dụng cách giám sát này.
Ta sẽ xây một mạng rất nhỏ với phần đầu dùng chung, một tầng phía sau và hai đầu phân lớp. Mục tiêu là đo chính xác tham số nào nhận gradient từ từng mất mát. Bạn sẽ kiểm chứng quy tắc cộng gradient và tạo một lỗi detach có chủ ý để thấy mất mát vẫn có giá trị dù đường cập nhật đã bị cắt.
Bạn nên biết backward, cross entropy và vai trò của đồ thị tính toán. Bài không so sánh độ chính xác của hai mạng sau huấn luyện. Mọi trọng số được đặt cố định để kết quả dễ đối chiếu. Chương trình dùng PyTorch 2.13.0 trên CPU và không cần tập ảnh hay GPU.
py -m venv .venv
.\.venv\Scripts\python.exe -m pip install numpy matplotlib
.\.venv\Scripts\python.exe -m pip install torch --index-url https://download.pytorch.org/whl/cpu
Ý nghĩa đoạn mã
Tạo môi trường trong thư mục thực hành. Trên macOS hoặc Linux, dùng python3 và đường dẫn .venv/bin/python thay cho đường dẫn Windows. Các tensor trong bài chạy trên CPU.
BƯỚC 02
Viết mục tiêu và chia tham số theo đường đi
Gọi mất mát chính là , mất mát phụ là và hệ số không âm là alpha. Ta dùng
BƯỚC 03
Một mạng nhỏ với đường đạo hàm rõ ràng
Đầu vào là 16 giá trị trải đều từ −1 đến 1, đặt trên lưới 4×4. Nhãn bằng một khi đầu vào dương và bằng không ở nửa còn lại. Tầng stem có trọng số 0,8 rồi đi qua tanh. Nhánh chính dùng thêm tầng late trọng số 0,7, còn nhánh phụ đọc trực tiếp đặc trưng sau tanh.
Hai đầu phân lớp có trọng số khác nhau để tạo hai mất mát và hai tín hiệu gradient khác nhau. Ta tính riêng gradient theo stem của từng mất mát trước khi tính mục tiêu kết hợp. Ba mức alpha bằng 0, 0,4 và 1 được kiểm tra trên cùng một đồ thị, cùng dữ liệu và cùng trọng số.
Cuối chương trình, shared.detach tạo một bản tách của đặc trưng cho nhánh phụ. Giá trị forward giữ nguyên, nhưng mất mát ấy không còn đường đi tới stem. Kiểm tra allow_unused trả None ở trường hợp này. Đây là cách mô phỏng một lỗi thường khó phát hiện nếu chỉ nhìn số mất mát được in ra.
from pathlib import Path
import json
import torch
from torch import nn
from torch.nn import functional as F
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt

torch.set_num_threads(1)
torch.set_default_dtype(torch.float64)
x = torch.linspace(-1, 1, 16).reshape(1, 1, 4, 4)
target = (x[:, 0] > 0).long()
stem = nn.Conv2d(1, 1, 1, bias=False)
late = nn.Conv2d(1, 1, 1, bias=False)
main = nn.Conv2d(1, 2, 1, bias=False)
aux = nn.Conv2d(1, 2, 1, bias=False)
with torch.no_grad():
    stem.weight.fill_(0.8)
    late.weight.fill_(0.7)
    main.weight.copy_(torch.tensor([1., -1.]).reshape(2, 1, 1, 1))
    aux.weight.copy_(torch.tensor([1.3, -0.6]).reshape(2, 1, 1, 1))
shared = torch.tanh(stem(x))
main_logits = main(late(shared))
aux_logits = aux(shared)
assert main_logits.shape == aux_logits.shape == (1, 2, 4, 4)
loss_main = F.cross_entropy(main_logits, target)
loss_aux = F.cross_entropy(aux_logits, target)
g_main = torch.autograd.grad(loss_main, stem.weight, retain_graph=True)[0]
g_aux = torch.autograd.grad(loss_aux, stem.weight, retain_graph=True)[0]
g_late = torch.autograd.grad(loss_main, late.weight, retain_graph=True)[0]
g_aux_head = torch.autograd.grad(loss_aux, aux.weight, retain_graph=True)[0]
alphas = [0., 0.4, 1.]
rows, errors = [], []
for alpha in alphas:
    total = loss_main + alpha * loss_aux
    gs, gl, ga = torch.autograd.grad(total, [stem.weight, late.weight, aux.weight],
                                   retain_graph=True)
    error = (gs - (g_main + alpha * g_aux)).abs().max().item()
    assert error < 1e-12
    assert torch.allclose(gl, g_late, atol=1e-12)
    assert torch.allclose(ga, alpha * g_aux_head, atol=1e-12)
    rows.append([gs.item(), gl.item(), ga.norm().item()])
    errors.append(error)

# Detaching preserves this loss value but cuts its path into the stem.
detached_loss = F.cross_entropy(aux(shared.detach()), target)
detached_gradient = torch.autograd.grad(detached_loss, stem.weight,
                                       allow_unused=True, retain_graph=True)[0]
assert detached_gradient is None
assert torch.allclose(detached_loss, loss_aux)

out = Path(__file__).resolve().parent / 'results'
out.mkdir(exist_ok=True)
plt.rcParams.update({'font.size': 11, 'figure.facecolor': '#f3f7f3'})
fig, ax = plt.subplots(1, 3, figsize=(13, 4), constrained_layout=True)
ax[0].imshow(target[0], cmap='coolwarm', vmin=0, vmax=1)
ax[0].set_title('Synthetic target: two regions')
ax[0].set_xticks([])
ax[0].set_yticks([])
ax[1].bar(['main', 'aux'], [loss_main.item(), loss_aux.item()],
          color=['#357a69', '#de873f'])
ax[1].set(ylabel='Mean cross entropy', title='Unweighted losses')
for i, (alpha, row) in enumerate(zip(alphas, rows)):
    ax[2].bar(torch.arange(3).numpy() + (i-1)*0.25, row, width=0.25,
              label=f'alpha={alpha}', color=['#637aad', '#de873f', '#357a69'][i])
ax[2].set_xticks([0, 1, 2], ['stem derivative', 'late derivative', 'aux grad norm'])
ax[2].tick_params(axis='x', rotation=15)
ax[2].set(ylabel='Gradient', title='Which parameters receive supervision?')
ax[2].legend()
fig.savefig(out / 'segmentation-auxiliary-loss.png', dpi=160)
metrics = {'loss_main': loss_main.item(), 'loss_aux': loss_aux.item(),
           'stem_gradient_main': g_main.item(), 'stem_gradient_aux': g_aux.item(),
           'alphas': alphas, 'gradient_rows': rows,
           'additivity_max_error': max(errors),
           'detached_aux_reaches_stem': detached_gradient is not None}
(out / 'segmentation-auxiliary-loss.json').write_text(
    json.dumps(metrics, indent=2), encoding='utf-8')
print(json.dumps(metrics))
BƯỚC 04
Đọc gradient thay vì chỉ nhìn tổng mất mát
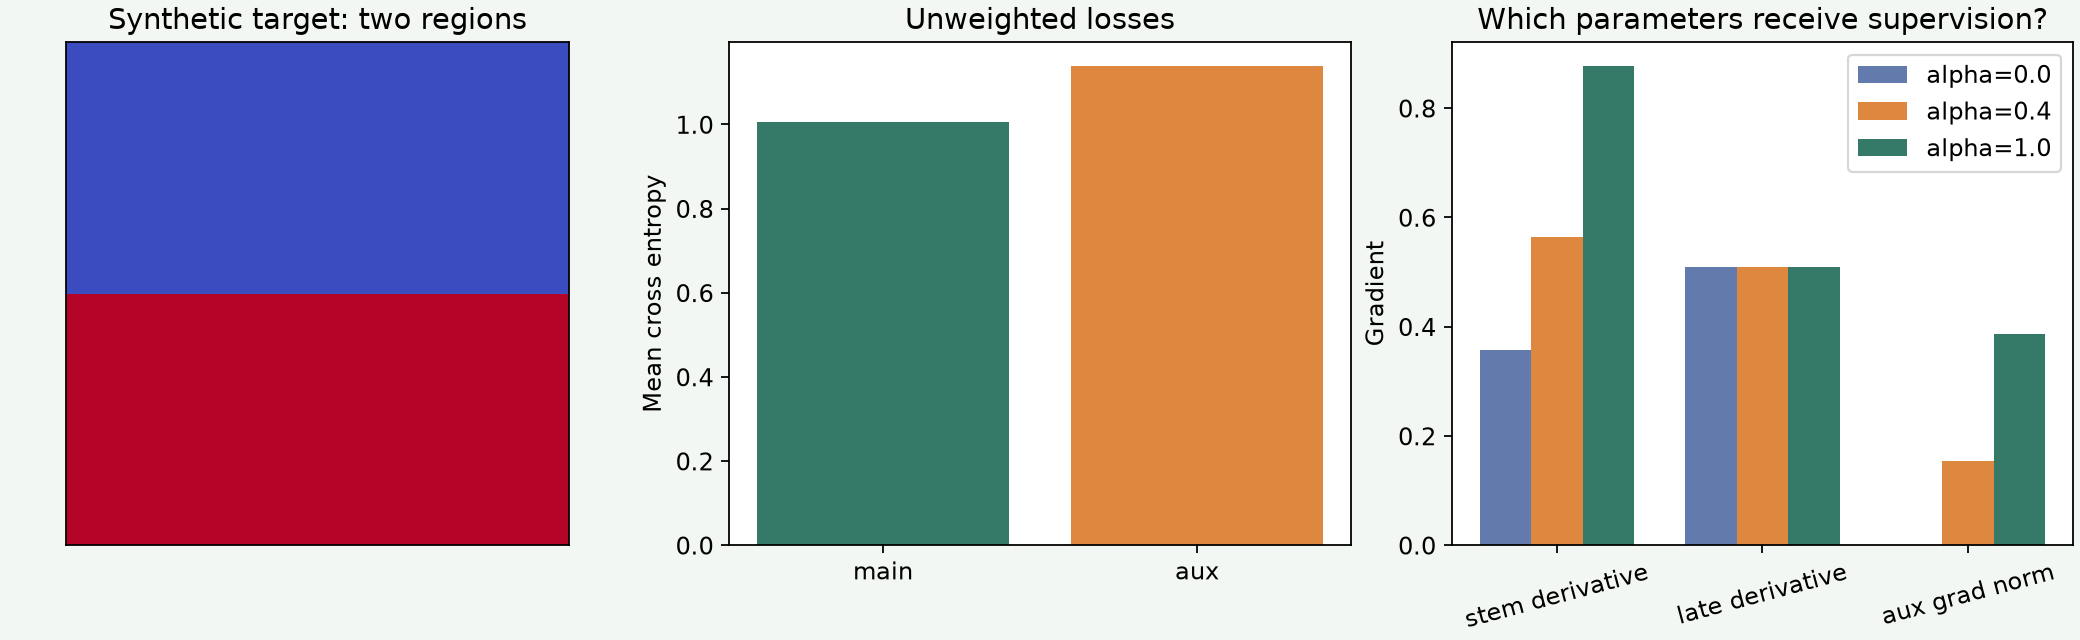
Mất mát chính bằng khoảng 1,006416 và mất mát phụ bằng 1,138468. Gradient riêng theo trọng số stem lần lượt bằng 0,356802 và 0,520030. Khi alpha bằng 0,4, gradient kết hợp là 0,564814, đúng bằng gradient chính cộng 0,4 lần gradient phụ. Sai số kiểm tra tính cộng bằng không trong lần chạy đã ghi nhận.
Đạo hàm theo tầng late giữ nguyên khoảng 0,508623 ở cả ba mức alpha vì tầng ấy chỉ nằm trên nhánh chính. Chuẩn gradient của đầu phụ lần lượt bằng 0, 0,154735 và 0,386836. Cột thứ ba là chuẩn vector, còn hai cột đầu là đạo hàm của tham số vô hướng nên cần đọc đúng tên trục.
Ở kiểm tra detach, giá trị mất mát phụ không đổi nhưng gradient tới stem không tồn tại. Hình minh họa phân biệt những nhóm tham số được cập nhật. Không có vòng tối ưu trong mã, nên các con số mô tả một trạng thái của mạng, chưa nói cách huấn luyện nào hội tụ nhanh hơn.
.\.venv\Scripts\python.exe segmentation-auxiliary-loss.pyÝ nghĩa đoạn mã
Chạy sau khi đã lưu tệp Python. Cửa sổ lệnh in số liệu JSON. Mở hình PNG trong thư mục results để đối chiếu với phần phân tích.
BƯỚC 05
Đưa nhánh phụ vào vòng huấn luyện thật
Trong một vòng huấn luyện, bạn thường tính cả hai mất mát rồi gọi backward trên tổng một lần. Chỉ cần giữ đồ thị nhiều lần như chương trình khi đang phân tích từng thành phần. Dùng retain_graph theo thói quen trong mọi bước có thể làm tốn bộ nhớ không cần thiết.
Hai đầu có thể trả độ phân giải khác nhau. Một cách nhất quán là nội suy logit của từng đầu về kích thước target trước cross entropy. Nếu phải đổi kích thước mask nhãn, cần giữ mã lớp rời rạc và quy ước vùng bỏ qua. Không nội suy bilinear trực tiếp trên mã lớp rồi coi các giá trị trung gian là nhãn hợp lệ.
PSPNet dùng nhánh phụ trong quá trình tối ưu và bỏ nhánh đó khi dự đoán cuối theo thiết kế bài báo. Tuy nhiên một thư viện có thể vẫn trả khóa aux trong cấu trúc đầu ra nếu mô hình được xây có đầu phụ. Hãy xác định rõ khóa nào dùng cho dự đoán và cách triển khai của mô hình đang chạy.
BƯỚC 06
Alpha cần được kiểm tra trên dữ liệu riêng
Giá trị 0,4 trong bài là một điểm thử thuận tiện để nhìn phép cộng gradient. Nó không phải bảo đảm cho mọi kiến trúc hoặc tập dữ liệu. Mức phù hợp còn phụ thuộc vị trí gắn nhánh, số lớp, cách gộp mất mát và độ lớn gradient của mỗi phần tại thời điểm huấn luyện.
Nếu hai gradient ở phần dùng chung ngược hướng, tăng alpha có thể làm một số thành phần nhỏ đi hoặc đảo chiều. Vì vậy chỉ nhìn tổng chuẩn gradient lớn hơn không đủ để kết luận giám sát tốt hơn. Muốn nghiên cứu sâu hơn, có thể đo tích vô hướng hoặc cosine giữa hai vector gradient trên cùng batch.
Thí nghiệm hiện tại dùng nhãn và mạng nhỏ để xác nhận đường tính toán. Nó chưa đo khả năng tổng quát hóa, chất lượng biên hay ảnh hưởng của nhiễu nhãn. Trong dự án thật, theo dõi riêng mất mát chính, mất mát phụ và chỉ số đánh giá của đầu chính trên tập validation. Chọn alpha bằng những tiêu chí đó thay vì chỉ làm tổng mất mát giảm.
ĐẾN LƯỢT BẠN
Thử một thay đổi nhỏ
- Thay nhãn của nhánh phụ bằng 1 − target nhưng giữ nhãn chính.
- Đo lại hai gradient theo stem và xem chúng có cùng dấu không.
- Tìm một alpha làm gradient kết hợp gần bằng không nếu hai gradient trái dấu.
- Sau đó bỏ detach ở phép thử cuối và xác nhận gradient tới stem xuất hiện trở lại, dù giá trị forward của mất mát không đổi.
- Khi đổi cấu hình, tính lại giá trị kỳ vọng trước khi cập nhật các assert liên quan.